Ha egy karakterláncban akarunk egy adott részkarakterláncot (mintát) keresni, akkor erre a str.find() vagy str.index() metódusokat lehet használni. Mindkettő a minta első előfordulásának indexével tér vissza, ha van találat. Ha nincs, akkor a str.find() visszatérési értéke -1, a str.index() pedig ValueError kivételt dob.
E két metódus azonban csak str típusú karakterláncokra hívható meg. Ezért, ezek nem használhatók, ha az a feladat, hogy
- egy olyan nagyméretű szöveges fájlban kell keresni egy adott mintát, hogy a fájltartalom nem olvasható egyszerre be a memóriába, vagy
- a vizsgálatot egy olyan karaktersorozaton kell végezni, amelynek karaktereit egy iterálható objektum szolgáltatja.
Mivel a szabványos könyvtárban nem áll rendelkezésre olyan függvény vagy metódus, amellyel ilyen esetekben a keresést el lehet végezni, ezért magunknak kell készíteni egyet, amely iterálható objektumot fogad, és egyet, amely egy fájlobjektumot.
A keresőfüggvényünkkel szembeni elvárások a következők:
- a keresés folyamán a memóriafelhasználást tudjuk kontrollálni.
- ne csak az első, hanem az összes előfordulás pozícióindexét kapjuk meg.
- a keresés az átlapolódó találatokat is vegye figyelembe.
Az utolsó két feltétel miatt célszerű, ha generátorfüggvényt készítünk, mert hosszú sorozat és sok átlapolódás esetén a kapott indexek sorozata is hosszú lehet. Generátorfüggvénnyel viszont egy olyan generátorobjektumot kapunk, amelyből egyesével lehet kikérni a pozícióindexeket. Ha csak az első előfordulásra van szükségünk, akkor csak egyszer kérjük ki a generátorból az értéket.
Ha a függvényünk az összes előfordulást megkeresi, akkor azért célszerű az átlapolódó minták pozícióját is meghatározni, mert lehet olyan használati eset, amikor ezek kellenek. Ha pedig csak a nem átlapolódókra van szükség, akkor a kapott indexeksorozatból ezek viszonylag egyszerűen kiszűrhetők.
A memóriafelhasználást úgy tudjuk kontrollálni, ha a beérkező karaktereket megadható hosszúságú blokkokban (chunk) dolgozzuk fel.
Ez azt jelenti, hogy a beérkező karaktereket a megadott hosszúságú karakterlánccá egyesítjük (fájlban keresésnél ekkora blokkokban olvasunk be), és a blokkon végezzük a tényleges keresést. Ezt a blokkra mint karakterláncra meghívott find() függvénnyel valósítjuk meg, mert ez C-ben futó, optimalizált függvény, ami nagyon gyorsan végzi a keresést (sokkal gyorsabban, mintha Python kódban valósítanánk meg). Azt azonban figyelembe kell venni, hogy a str.find() csak az első előfordulást keresi meg.
Amire a blokkonkénti feldolgozásnál ügyelni kell, hogy előfordulhat, hogy egy minta egyik blokkból átnyúlik a következőbe. Ezért a keresést valójában nem egy blokkon, hanem az előző blokk megfelelően hosszú vége és az új blokk egyesítésével létrejövő karakterláncon (keresőszakasz) kell végezni.
A keresőszakaszhoz az előző blokk megfelelő hosszú végének meghatározásakor a leghosszabb esetet kell figyelembe venni. Ez akkor van, amikor a minta csak egyetlen karaktere esik a következő blokk elejére, a többi a jelenlegi blokk végére. Tehát minden egyes kereső szakasz eleje az előző blokk utolsó mintahossz-1 darab karakterével egyezik meg. Mindezt vizuálisan a következő ábra szemlélteti.
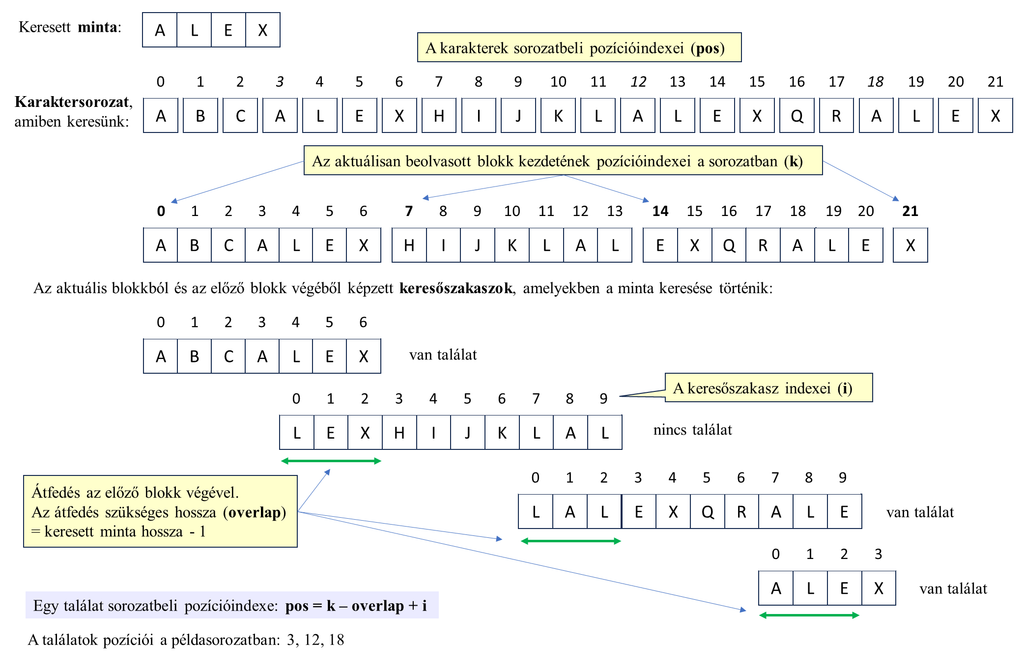
A fenti elvek alapján megvalósított find_in_iterable() és find_in_file() függvények definícióit láthatjuk alább. A részletes kommentek segítik a működés megértését.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 |
from collections.abc import Iterable, Iterator from itertools import islice def find_in_iterable(s: Iterable[str], sub: str, start: int | None = None, end: int | None = None, chunk_size: int = 10000) -> Iterator[int]: """Egy olyan generátorobjektummal tér vissza, amely kiadja azokat a pozíciókat, ahol a 'sub' részsorozat megtalálható az 's' iterálható objektum által szolgáltatott karaktersorozatban. A függvény a karaktereket nem egyszerre kéri be, hanem 'chunk_size' hosszú szakaszokban. A 'chunk_size' értéke olyan pozitív egész szám kell, hogy legyen, amelynél a 'sub' hossza legfeljebb eggyel nagyobb. A 'start' és 'end' paraméterek jelentése megegyezik a str.find() megfelelő paramétereinek jelentésével: a 'start' pozíciótól kezdve, de az 'end' pozíciót már nem beleértve történik a keresés. Ha 'start' értéke None, akkor a keresés az első elemtől (0 pozíciótól) kezdődik. Ha 'end' értéke None, akkor a keresés a sorozat végéig tart. A 'start' és 'end' értéke nem lehet negatív. Paraméterek: s: A karaktereket szolgáltató iterálható objektum. Az iteráció minden lépésben egy karaktert szolgáltat. sub: A keresett részsorozat. start: A keresés kezdőpozíciója. Ha értéke az alapértelmezett None, a keresés a 0. pozíciótól indul. end: A keresési tartomány végét jelentő pozíció, ahol már nincs keresés. Ha értéke az alapértelmezett None, a keresés addig folytatódik, amíg az iterálható objektum tud karaketert kiadni. chunk_size: az iterálható objektumból egyszerre kikért karakterszakasz hossza. Visszatérési érték: Iterátor, amely a 'sub' előfordulási pozícióit szolgáltatja a megadott tartományban, vagy -1 értéket, ha a részsorozat nem található. ValueError kivétel keletkezik ha - a 'start' vagy az 'end' értéke nem 'None' és nem nemnegatív egész szám, - a 'start' nagyobb az 'end' értékénél, - a 'sub' üres karakterlánc, - a 'chunk_size' értéke kisebb a megengedett minimumnál. """ # Kivételt dobunk, ha a keresett részsorozat üres karakterlánc. if sub == '': raise ValueError(f'A "sub" argumentum nem lehet üres karakterlánc') # Ellenőrizzük, hogy a nem None kezdő- és végpozíciók nemnegatív egész számok. def check_index_nonnegative(position_index: int | None, parameter_name: str) -> None: if position_index is not None and (not type(position_index) is int or position_index < 0): raise ValueError(f'Az "{parameter_name}" argumentum nemnegatív egész szám kell, hogy legyen') check_index_nonnegative(start, 'start') check_index_nonnegative(end, 'end') min_chunk_size = max(1, len(sub) - 1) if type(chunk_size) is not int or chunk_size < min_chunk_size: raise ValueError(f'A "chunk_size" értéke legalább {min_chunk_size} értékű pozitív egész szám kell, hogy legyen.') start = 0 if start is None else start # Ellenőrizzük, hogy a kezdőpozíció kisebb-e, mint a végpozíció. if end is not None and start > end: raise ValueError(f'A "start" nem lehet nagyobb, mint az "end"') # Előállítjuk azt az iterátort, amely a start és end pozíciók között szolgáltat karaktereket. s_iter: Iterator[str] = islice(s, start, end) # Az előző chunk végéről átvett karakterek maximális száma. overlap_size = len(sub) - 1 overlap = '' # Az aktuális chunk kezdőpozíciója az eredeti s-ben. chunk_start = start sub_found = False while True: # Képezzük a chunk_size hosszú karakterszakaszt. chunk = ''.join(islice(s_iter, chunk_size)) if not chunk: break # Az előző blokk végéről megtartott karaktereket hozzáfűzzük az aktuális chunk elejéhez. Erre azért van # szükség, mert a keresett részszöveg két egymást követő chunk határán is elhelyezkedhet. search_chunk = overlap + chunk # Az aktuális keresőszakaszban keressük a sub előfordulásait. index_in_search_chunk = 0 while True: # Megkeressük a sub előfordulását a keresőszakaszban, az adott keresési indextől. index_in_search_chunk = search_chunk.find(sub, index_in_search_chunk, None) # Ha találtunk egyezést, a keresési szakaszon belüli pozíciót átszámítjuk a # teljes sorozaton belüli pozícióra. if index_in_search_chunk != -1: absolute_position = chunk_start - len(overlap) + index_in_search_chunk # Csak az aktuális keresési tartományban kezdődő találat érvényes. if absolute_position >= start: sub_found = True yield absolute_position index_in_search_chunk += 1 else: break # Ha nincs találat, a következő kereséshez megtartjuk az aktuális chunk végét, és ezt fűzzük majd az # új chunk elejéhez. Legfeljebb len(sub) - 1 karakterre van szükségünk, mert ha a sub átnyúlik a # chunk határán, legalább egy karaktere az aktuális chunkban van. overlap = chunk[-overlap_size:] if overlap_size else '' # Meghatározzuk a következő chunk kezdőpozícióját. chunk_start += len(chunk) # Nincs találat. if not sub_found: yield -1 |
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 |
from collections.abc import Iterator def find_in_file(file_object, sub: str, start: int | None = None, end: int | None = None, chunk_size: int = 10000) -> Iterator[int]: """Egy olyan generátorobjektummal tér vissza, amely kiadja azokat a pozíciókat, ahol a 'sub' részsorozat megtalálható a 'file_object' fájlban. A fájlból a karaktereket nem egyszerre olvassa be, hanem 'chunk_size' hosszú szakaszokban. A 'chunk_size' értéke olyan pozitív egész szám kell, hogy legyen, amelynél a 'sub' hossza legfeljebb eggyel nagyobb. A 'start' és 'end' paraméterek jelentése megegyezik a str.find() megfelelő paramétereinek jelentésével: a 'start' pozíciótól kezdve, de az 'end' pozíciót már nem beleértve történik a keresés. Ha 'start' értéke None, akkor a keresés a fájl elején kezdődik. Ha 'end' értéke None, akkor a keresés a fájl végéig tart. A 'start' és 'end' értéke nem lehet negatív. A fájl végét meghaladó értékek a fájl végére korlátozódnak. Paraméterek: file_object: Az az olvasásra megnyitott szövegfájl, amelyben keresünk. sub: A keresett részsorozat. start: A keresés kezdőpozíciója. Ha értéke az alapértelmezett None, a keresés a 0. pozíciótól indul. end: A keresési tartomány végét jelentő pozíció, ahol már nincs keresés. Ha értéke az alapértelmezett None, a keresés a fájl végéig folytatódik. chunk_size: a fájlból egyszerre beolvasott karakterszakasz hossza. Visszatérési érték: Iterátor, amely a 'sub' előfordulási pozícióit szolgáltatja a megadott tartományban, vagy -1 értéket, ha a részsorozat nem található. ValueError kivétel keletkezik ha - a file_object nem olvasásra megnyitott fájlobjektum. - a 'start' vagy az 'end' értéke nem 'None' és nem nemnegatív egész szám, - a 'start' nagyobb az 'end' értékénél, - a 'sub' üres karakterlánc, - a 'chunk_size' értéke kisebb a megengedett minimumnál. """ if not file_object.readable(): raise ValueError('Az első argumentum olvasásra megnyitott fájlobjektum kell, hogy legyen.') # Kivételt dobunk, ha a keresett részsorozat üres karakterlánc. if sub == '': raise ValueError(f'A "sub" argumentum nem lehet üres karakterlánc') # Ellenőrizzük, hogy a nem None kezdő- és végpozíciók nemnegatív egész számok. def check_index_nonnegative(position_index: int | None, parameter_name: str) -> None: if position_index is not None and (not type(position_index) is int or position_index < 0): raise ValueError(f'Az "{parameter_name}" argumentum nemnegatív egész szám kell, hogy legyen') check_index_nonnegative(start, 'start') check_index_nonnegative(end, 'end') min_chunk_size = max(1, len(sub) - 1) if type(chunk_size) is not int or chunk_size < min_chunk_size: raise ValueError(f'A "chunk_size" értéke legalább {min_chunk_size} értékű pozitív egész szám kell, hogy legyen.') start = 0 if start is None else start # Ellenőrizzük, hogy a kezdőpozíció kisebb-e, mint a végpozíció. if end is not None and start > end: raise ValueError(f'A "start" nem lehet nagyobb, mint az "end"') position = 0 # A következő chunk kezdőpozícióját mutatja a fájlban. # A start pozíció eléréséig szakaszokban (chunk) olvasunk, és az adatot eldobjuk. Erre azért van # szükség, mert így nem kell a start előtti teljes fájlrészt memóriában tartani. # A beolvasásra pedig azért van szükség, mert szöveges stream esetén a seek() argumentuma nem # használható általános karakterindexként. while position < start: chunk = file_object.read(min(chunk_size, start - position)) if not chunk: # A fájl vége a start pozíció elérése előtt következett be. yield -1 return position += len(chunk) overlap = "" sub_found = False while end is None or position < end: read_size = chunk_size if end is not None: read_size = min(read_size, end - position) if not (chunk := file_object.read(read_size)): break # Az előző chunk végéről megtartott karaktereket hozzáfűzzük az aktuális chunk elejéhez. # Erre azért van szükség, mert a keresett részszöveg két egymást követő chunk határán # is elhelyezkedhet. search_chunk = overlap + chunk # Az aktuális keresőszakaszban keressük a sub előfordulásait. index_in_search_chunk = 0 while True: # Megkeressük a sub előfordulásait a keresőszakaszban. index_in_search_chunk = search_chunk.find(sub, index_in_search_chunk, None) # Ha találtunk egyezést, a keresőszakaszon belüli pozíciót átszámítjuk a # teljes fájlon belüli pozícióra. if index_in_search_chunk != -1: found_position = position - len(overlap) + index_in_search_chunk # A találat kezdőpozíciója a [start, end) tartományban van, és a teljes sub is belefér a # keresési tartományba. if end is None or found_position + len(sub) <= end: sub_found = True yield found_position index_in_search_chunk += 1 else: break # Ha nincs találat, a következő kereséshez megtartjuk az aktuális chunk végét, és ezt fűzzük majd az # új chunk elejéhez. Legfeljebb len(sub) - 1 karakterre van szükségünk, mert ha a sub átnyúlik a # chunk határán, legalább egy karaktere az aktuális chunkban van. overlap_size = len(sub) - 1 overlap = chunk[-overlap_size:] if overlap_size else '' # Meghatározzuk a következő chunk kezdőpozícióját. position += len(chunk) # Nincs találat. if not sub_found: yield -1 |
A függvények teszteléséhez olyan nagyméretű fájlokra van szükségünk, amelyek méretét előre meg tudjuk határozni, és el tudjuk bennük helyezni egy megadható pozícióba a keresendő karakterláncot, vagyis a mintát. A mintán felüli karaktereket véletlenszerűen állítjuk elő. Ahhoz, hogy a keresést ne csak ASCII karakterekre teszteljük, ékezetes betűket is szerepeltetünk mind a mintában, mind a véletlenszerűen előállított karakterek között.
A keresési idő mérését minden fájlméret esetében a legrosszabb esetre végezzük el. Ehhez a mintát a fájlok végére helyezzük. Hosszú sorozatok esetén azonban a minta előfordulása a véletlenszerűen előállított szakaszon is előfordulhat. Érdemes megbecsülni, hogy egy adott sorozat- és mintahossz estén hány előfordulás várható. Ezzel azt is tervezni tudjuk, hogy milyen hosszú sorozatoknál lesz a minta szinte biztosan csak a fájl végén, is mi az a határ, ahol már több előfordulás is várható. Az utóbbi esetben a függvényeinknek az összes előfordulás pozícióját ki kell adniuk. Ezzel egyúttal a véletlen eloszlásra tett feltételezéseket is tesztelni tudjuk.
A hosszú karaktersorozatokat tartalmazó nagyméretű fájlok létrehozásához szükséges tervezési képletek levezetése a következő ábrákon követhető.
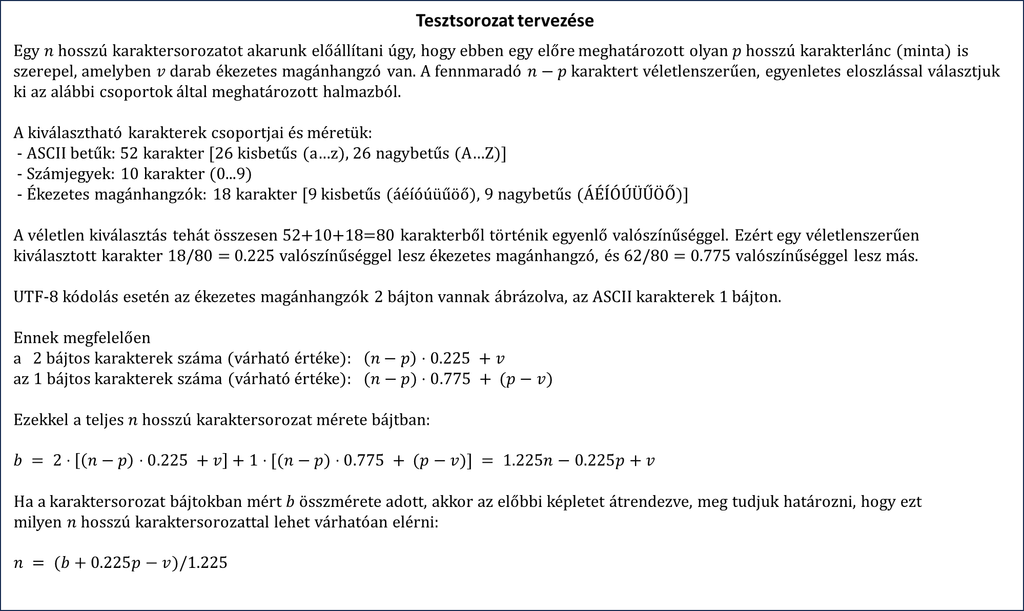
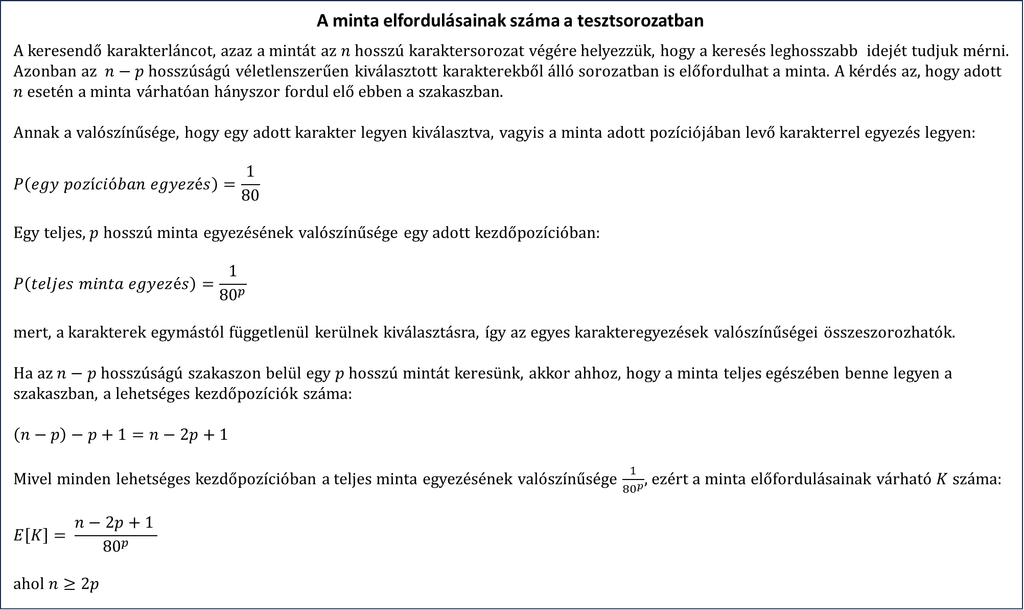
A fenti képleteket felhasználó fájl- és karaktersorozatelőállító függvények definíciói, valamint a fájlokat létrehozó kódsor az alábbi.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 |
import random import string from collections.abc import Iterator def gen_random_chars(num_chars: int, pattern='', index: int | None = None) -> Iterator[str]: """Egyesével szolgáltat véletlenszerűen generált 'num_chars' számú karaktert úgy, hogy az 'index' pozíciótól kezdődően (az 'index' pozíciót is beleértve) a 'pattern' argumentum karaktereit adja ki. Ha az 'index' értéke None, akkor a 'pattern' karakterei lesznek legutoljára kiadva. A generált karakterek a latin kis- és nagybetűk, a számjegyek, valamint a magánhangzók ékezetes megfelelői közül kerülnek ki. """ vowels_with_acute = 'áéíóúüűöő' cap_vowels_with_acute = ''.join([c.upper() for c in vowels_with_acute]) base_chars = string.ascii_letters + string.digits + vowels_with_acute + cap_vowels_with_acute for i in range(num_chars - len(pattern)): if i == index: yield from pattern yield random.choice(base_chars) if index is None: yield from pattern def create_random_text_file(file_path: str, num_chars: int, pattern='', index: int | None = None) -> None: """Létrehozza a 'file_path' által megadott szövegfájlt, amely összesen num_chars számú véletlenszerű karaktert tartalmaz. A kiírt karaktereket a gen_random_chars() függvény szolgáltatja. Ennek megfelelően a karakterek a latin kis- és nagybetűk, a számjegyek, valamint a magánhangzók ékezetes megfelelői közül kerülnek ki. Az 'index' pozíciótól kezdődően (az 'index' pozíciót is beleértve) a 'pattern' argumentum karaktereit szúrja be. Ha az 'index' értéke None, akkor a fájlban utolsóként a 'pattern' karakterei szerepelnek. """ char_gen = gen_random_chars(num_chars, pattern, index) with open(file_path, mode='w', encoding='utf-8', newline='') as f: for c in char_gen: f.write(c) def char_stream(file_path: str, chunk_size: int = 5000000) -> Iterator[str]: """A megadott szövegfájl tartalmát karakterenként adja ki sorvégkarakter-átalakítások nélkül. A fájl teljes tartalmának memóriába töltése és a lemez-I/O műveletek számának csökkentése érdekében a fájl tartalma 'chunk_size' hosszú blokkokban kerül beolvasásra. A 'chunk_size' az egy olvasási művelet során beolvasandó karakterek maximális száma. """ with open(file_path, 'r', encoding='utf-8', newline='') as f: while chunk := f.read(chunk_size): yield from chunk def get_num_chars(file_path: str) -> int: """Visszaadja a megadott szövegfájlban tárolt karakterek számát.""" char_count = 0 with open(file_path, 'r', encoding='utf-8', newline='') as f: while chunk := f.read(1000000): char_count += len(chunk) return char_count def expected_bytes_for_chars(num_chars: int, pattern_length: int, num_2byte_chars_in_pattern: int) -> int: """Visszaadja a num_chars számú karakterből álló karaktersorozat várható UTF-8 kódolású bájtméretét. E karaktersorozatban szerepel egy pattern_length hosszú karakterlánc, amelyben 1 és 2 bájton ábrázolt karaketerek vannak úgy, hogy a 2 bájtos karakter száma num_2byte_chars_in_pattern. A fennmaradó karakterek között egyenletes eloszlással szerepel a 62 darab 1 bájtos ASCII karakter (kis- és nagybetű és számjegyek) és 18 darab 2 bájtos (a magánhangzók kis- és nagybetűs megfelelője). """ return round(1.225 * num_chars - 0.225 * pattern_length + num_2byte_chars_in_pattern) def expected_chars_for_bytes(num_bytes: int, pattern_length: int, num_2byte_chars_in_pattern: int) -> int: """Visszaadja a num_bytes bájtméretű UTF-8 kódolású adat várható eléréséhez szükséges karakterszámot. A karaktersorozatban egy pattern_length hosszúságú, fix karakterlánc található, amelyben num_2byte_chars_in_pattern darab, UTF-8-ban 2 bájton ábrázolt karakter van. A fennmaradó karakterek között egyenletes eloszlással szerepel a 62 darab 1 bájtos ASCII karakter (kis- és nagybetű és számjegyek) és 18 darab 2 bájtos (a magánhangzók kis- és nagybetűs megfelelője). """ return round((num_bytes + 0.225 * pattern_length - num_2byte_chars_in_pattern) / 1.225) if __name__ == '__main__': # Különböző méretű szöveges tesztfájlok létrehozása, amelyekben a pattern karakterei az utolsók, a többi karakter a latin kis- és nagybetűk, a számjegyek, valamint a magánhangzók ékezetes megfelelői közül kerülnek ki véletlenszerűen, egyenletes eloszlással kiválasztva. Mbyte = 1024 * 1024 pattern = 'KöprÜ' pattern_length = len(pattern) num_2byte_chars_in_pattern = sum(1 for c in pattern if len(c.encode()) == 2) factors = (1, 10, 100, 1000, 10000) file_sizes_in_bytes = [i * Mbyte for i in factors] file_chars_counts = [expected_chars_for_bytes(file_size, pattern_length, num_2byte_chars_in_pattern) for file_size in file_sizes_in_bytes] file_names = [f'random_text_{i}MB_pattern{pattern_length}.txt' for i in factors] for file_name, num_chars in zip(file_names, file_chars_counts): print(file_name, num_chars) create_random_text_file(file_name, num_chars, pattern, None) |
A find_in_iterable() és find_in_file() függvények keresési idejének mérését végző programkód a következő.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 |
from time import perf_counter from source_generators import char_stream, get_num_chars def running_time_find_in_iterable(iterable, substring=''): start = perf_counter() indexes = list(find_in_iterable(iterable, substring)) stop = perf_counter() elapsed = stop - start print('Futási idő: {:.5f} s'.format(elapsed)) print(f'A {substring} karakterlánc a {indexes} pozíciónál kezdődik.') return elapsed, indexes, substring def running_time_find_in_file(filepath: str, substring: str): with open(filepath, 'r', encoding='UTF-8', newline='') as fileobj: start = perf_counter() indexes = list(find_in_file(fileobj, substring)) stop = perf_counter() elapsed = stop - start print('Futási idő: {:.5f} s'.format(elapsed)) print(f'A {substring} karakterlánc a {indexes} pozíciónál kezdődik.') return elapsed, indexes, substring # TESZT factors = (1, 10, 100, 1000, 10000) file_paths = [f'random_text_{i}MB_pattern5.txt' for i in factors] substring = 'KöprÜ' for file_path in file_paths: num_chars = get_num_chars(file_path) print(f'\nA {file_path.name} fájlban tárolt karakterek száma: {get_num_chars(file_path):_d}') print('---- find_in_iterable() ----') elapsed, indexes, substring = running_time_find_in_iterable(char_stream(file_path), substring) assert indexes[-1] + len(substring) == num_chars print('A keresett karakterlánc előfordulásainak száma:', len(indexes)) print('---- find_in_file() ----') elapsed, indexes, substring = running_time_find_in_file(file_path, substring) assert indexes[-1] + len(substring) == num_chars print('A keresett karakterlánc előfordulásainak száma:', len(indexes)) |
Az eredményeket az alábbi táblázat foglalja össze.
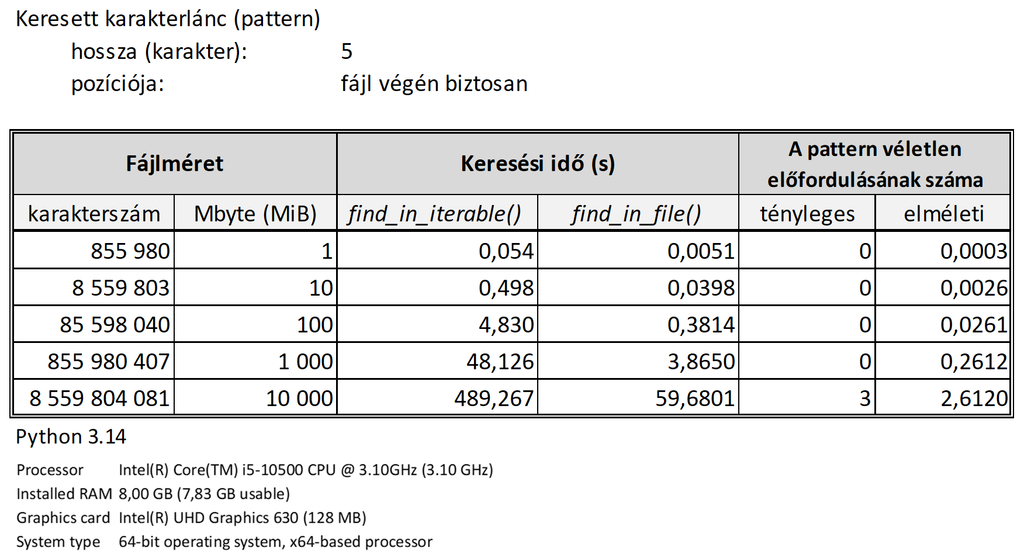
Amint az eredményekből láthatjuk, a keresés ideje a karakterek számával lineárisan nő. Ezt is vártuk, mert a str.find() metódus optimalizált keresési algoritmusa – adott keresendő minta esetén – legrosszabb esetben is, amikor a minta sorozat legvégén van, a bemeneti sorozat hosszával lineárisan növő végrehajtási időt biztosít.
Fájlban keresés esetén a linearitás csak az 1–1000 MiB tartományban igaz, 10000 MiB-os fájlméretnél az addigi trendből várthoz képest érzékelhetően magasabb a keresési idő. Ennek oka, hogy a kisebb fájlok a tesztelés során teljes terjedelmükben elfértek az operációs rendszer memóriabeli gyorsítótárában (Page Cache), így a keresés valójában a gyors RAM-ban zajlott. A 10000 MiB-os fájl viszont már túllépte a szabad lemez-cache keretét, ezért a feldolgozás sebességét itt már nem a CPU és a memória, hanem a fizikai háttértár lassabb olvasási sebessége határozta meg.
Az iterálható objektumra épülő változatnál a keresési idő egy nagyságrenddel (kb. 10-szeresére) nőtt, viszont a futási idő még a legnagyobb karakterszámnál is megőrizte a lineáris jelleget.
A lassulást a Python-szintű karakterenkénti feldolgozás okozza: a karakterláncszakaszok előállításánál az islice() és a ''.join() kombinációja nagyon sok belső műveletre (függvényhívások és ideiglenes memóriafoglalás) kényszeríti a Python interpretert. Ugyanakkor a linearitás éppen emiatt marad meg a teljes tartományban: a kód működése tisztán processzor-korlátossá (CPU-bound) vált. Mivel a C-alapú fájlolvasáshoz képest a Python-szintű ciklus sokkal lassabb, a feldolgozás sebességét itt már nem a lemez fizikai I/O korlátai vagy a Page Cache mérete, hanem kizárólag a CPU állandó tempójú számítási kapacitása határozza meg.
A bemutatott függvények megírásához számos Python nyelvi ismeret szükséges, amelyek megtalálhatók a Python tudásépítés lépésről lépésre az alapoktól az első asztali alkalmazásig című e-könyvben.