Tegyük fel, hogy adott egy UTF-8 kódolású szöveg bájtsorozata – például egy olvasásra megnyitott bináris fájlobjektum áll rendelkezésre – és ebből kívánjuk a kódolt karakterek (kódpontok) számát meghatározni.
Ezt a feladatot könnyen megoldhatjuk akkor, ha a teljes bájtsorozatot el tudjuk tárolni a számítógép memóriájában egy bytes típusú sorozatban. Ilyenkor egyszerűen meghívjuk e sorozat decode() metódusát amivel karakterlánccá konvertáljuk a bájtsorozatot, majd a len() függvénnyel meghatározzuk a karakterlánc hosszát.
Más a helyzet, ha az UTF-8 bájtsorozat nem fér be egyszerre a memóriába. Ilyenkor csak előre meghatározott méretű blokkokban tudjuk feldolgozni a bájtsorozatot, és valamilyen módszerrel következtetni a karakterek számára.
Két elvi megközelítést alkalmazhatunk ilyen esetben.
Az egyik az egyes blokkok dekódolásán és visszakódolásán alapul, vagyis ilyenkor a bytes.decode() és str.encode() metódusokat alkalmazzuk blokkszinten. Ennek fő lépései a következők:
- Dekódoljuk a blokk bájtjait úgy, hogy ha a végén esetleg csonka, azaz nem dekódolható karakter van, azt figyelmen kívül hagyjuk.
- A karakterszámlálót a dekódolt szöveg hosszával növeljük.
- Ezután meghatározzuk, hogy a blokkban sikeresen dekódolt szöveg hány bájton volt kódolva.
- A blokk maradék bájtjait a következő blokk elejéhez fűzzük, hogy ott már dekódolható legyen.
A blokkonkénti dekódolás és kódolás nem tűnik futási idő szempontjából hatékonynak, ezért más megoldást is meg kell vizsgálni. Ekkor azonban, mivel elvetjük a dekódolást, már csak bájtszinten tudunk dolgozni. Ehhez viszont bizonyos mértékig szükséges elmélyedni az UTF-8 kódolás részleteiben, mert a bájtok jellemzői alapján lehet majd következtetni a kódolt karakterekre, illetve azok számára. Az UTF-8 kódolás azon alapvető jellemzőit, amelyeket fel fogunk használni, a következő ábra foglalja össze.
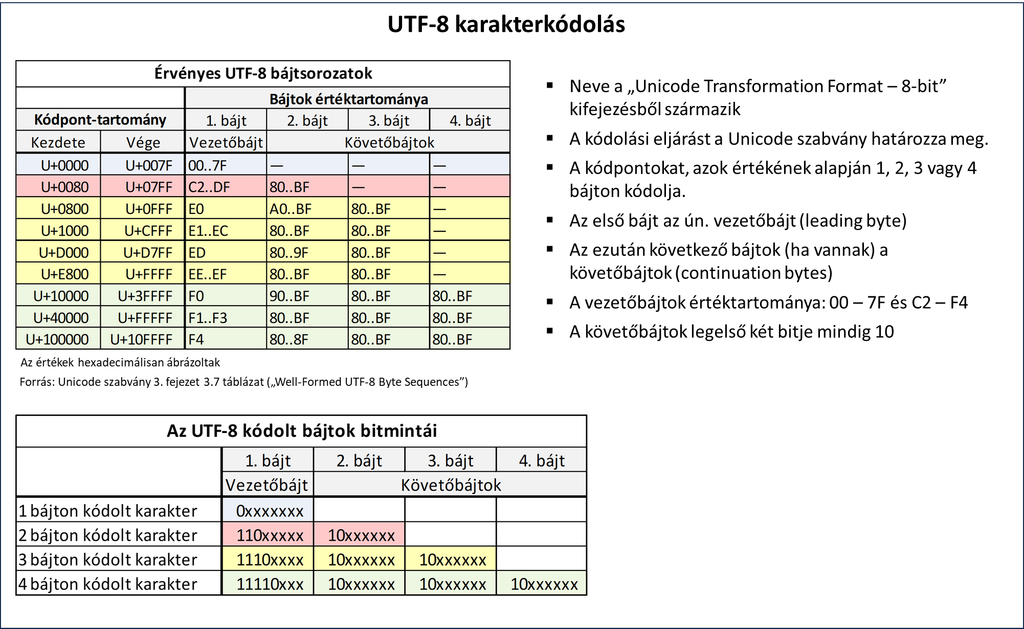
Ennek alapján első menetben két segédfüggvényt definiálunk, amelyek egyikével meg lehet állapítani egy érvényes UTF-8 bájtról, hogy az karakterkezdőbájt, azaz vezetőbájt, a másikkal pedig azt, hogy egy megadott vezetőbájt után hány követőbájtnak kell lenni. E függvények definícióit láthajuk alább. (A protolkoll osztályt és az importált modulokat később fogjuk használni)
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 |
from __future__ import annotations from typing import Protocol from itertools import repeat import operator as op class ReadableBinaryStream(Protocol): def read(self, size: int = -1, /) -> bytes: ... def readable(self) -> bool: ... class Byte(int): def __new__(cls, value: int | Byte) -> Byte: if isinstance(value, bool) or not isinstance(value, int): raise TypeError("A Byte értéke egész szám kell, hogy legyen.") if not 0 <= value <= 255: raise ValueError("A Byte értékének 0 és 255 közé kell esnie") return super().__new__(cls, value) def is_leading_byte(utf8_byte: Byte | int) -> bool: """True értékkel tér vissza, ha az argumentumként megadott bájt érvényes UTF-8-karakter kezdőbájtja lehet. Az értéktartományok forrása: - Unicode szabvány 3. fejezet 3.7 táblázat "Well-Formed UTF-8 Byte Sequences" - RFC 3629 4. fejezete, "Syntax of UTF-8 Byte Sequences” """ utf8_byte = Byte(utf8_byte) return 0x00 <= utf8_byte <= 0x7F or 0xC2 <= utf8_byte <= 0xF4 def num_continuation_bytes(utf8_byte: Byte | int) -> int: """Meghatározza az UTF-8-kezdőbájt után következő bájtok számát. Visszatérési értékek: 0–3: A követőbájtok száma érvényes UTF-8-kezdőbájt esetén. -1: Ha a bájt nem érvényes UTF-8-kezdőbájt. Annak forrása, hogy mely karakterkezdő bájtokhoz hány követőbájt társul: - Unicode szabvány 3. fejezet 3.7 táblázat "Well-Formed UTF-8 Byte Sequences" - RFC 3629 4. fejezete, "Syntax of UTF-8 Byte Sequences” """ utf8_byte = Byte(utf8_byte) if not is_leading_byte(utf8_byte): return -1 if utf8_byte <= 0x7F: return 0 elif utf8_byte <= 0xDF: return 1 elif utf8_byte <= 0xEF: return 2 else: return 3 |
Mindezek után nekiláthatunk a feladatunk megoldásához eltérő logikával működő, és ezért különböző nyelvi eszközket használó függvények készítéséhez.
Az egyes függvénydefiníciók láthatók a következőkben. Az első függvény a bytes.decode() és str.encode() metódusokat használó megoldás, a többi az UTF-8 kódolás jellemzőire épül. A működési alapelvük kommentben olvasható.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 215 216 217 218 219 220 221 222 223 224 225 226 227 |
# Az alábbi függvények mindegyike azt számolja meg, hogy az olvasásra megnyitott, UTF-8 kódolt bájtokat # tartalmazó bináris fájlban hány érvényes karakter (kódpont) van. A feldolgozás 'chunk_size' bájt hosszú # blokkokban történik. def count_chars_in_file1(binfileobj: ReadableBinaryStream, chunk_size: int = 1024 * 1024) -> int: if not binfileobj.readable(): raise ValueError("A fileobjektum nincs olvasásra megnyitva!") # Működési elv: # Dekódoljuk a blokk bájtjait úgy, hogy ha a végén esetleg csonka, azaz nem dekódolható # karakter van, azt figyelmen kívül hagyjuk. A karakterszámlálót a dekódolt szöveg hosszával növeljük. # Ezután meghatározzuk, hogy a blokkban sikeresen dekódolt szöveg hány bájton volt kódolva. # A blokk maradék bájtjait a következő blokk elejéhez fűzzük, hogy ott már dekódolható legyen. total_chars = 0 puffer: bytes = b"" # Ebben tároljuk a blokkhatáron megmaradt csonka karakter bájtjait. while chunk := binfileobj.read(chunk_size): # Ha az előző körből maradt csonka bájt, azt az új blokk elejére tesszük. chunk: bytes = puffer + chunk # Dekódoljuk a blokkot, a végén lévő esetleg csonka karaktert figyelmen kívül hagyva. decoded_text = chunk.decode('utf-8', errors='ignore') total_chars += len(decoded_text) # Kiszámoljuk, hogy a sikeresen dekódolt szöveg hány bájtot igényel. bytecount_processed: int = len(decoded_text.encode('utf-8')) # A chunk maradéka lesz a következő kör puffere. puffer = chunk[bytecount_processed:] # Ha már nincs több beolvasott bájt, a pufferben maradt bájtokat dekódoljuk. # Ahány érvényes karakter az eredmény, annyival növeljük a karakterszámlálót. if puffer: decoded_text = puffer.decode('utf-8', errors='ignore') total_chars += len(decoded_text) return total_chars # -------------------------------------------------------------------- def count_chars_in_file2(binfileobj: ReadableBinaryStream, chunk_size: int = 1024 * 1024) -> int: if not binfileobj.readable(): raise ValueError("A fileobjektum nincs olvasásra megnyitva!") # Működési elv: # A blokk beazonosított karakterkezdő bájtait egymás után megszámoljuk, majd ennek megfelelően # aktualizáljuk a karakterszámlálót. total_chars = 0 while chunk := binfileobj.read(chunk_size): leading_byte_count = sum(is_leading_byte(utf8_byte) for utf8_byte in chunk) total_chars += leading_byte_count return total_chars # -------------------------------------------------------------------- def count_chars_in_file3(binfileobj: ReadableBinaryStream, chunk_size: int = 1024 * 1024) -> int: if not binfileobj.readable(): raise ValueError("A fileobjektum nincs olvasásra megnyitva!") # Működési elv: # Megszámoljuk, hogy az egyes blokkokban hány követőbájt van. # Bármely UTF-8 követőbájt bitképe: 10xxxxxx. Ennek alapján a blokk minden egyes bájtjának felső két bitjét # kimaszkoljuk, és így kiszűrjük a követőbájtokat, és megszámoljuk azokat. Ezt levonva a blokk összes # bájtjának számából megkapjuk a karakterkezdő bájtok számát, amivel aktualizáljuk a karakterszámlálót. total_chars = 0 while chunk := binfileobj.read(chunk_size): # A követőbájtok száma. continuation_byte_count = sum(1 for b in chunk if (b & 0b11000000) == 0b10000000) # A blokkon belüli karakterkezdő bájtok számával aktualizáljuk a karakterszámlálót. total_chars += (len(chunk) - continuation_byte_count) return total_chars # -------------------------------------------------------------------- def count_chars_in_file4(binfileobj: ReadableBinaryStream, chunk_size: int = 1024 * 1024) -> int: if not binfileobj.readable(): raise ValueError("A fileobjektum nincs olvasásra megnyitva!") # Működési elv: # Megszámoljuk, hogy az egyes blokkokban hány követőbájt van. # Bármely UTF-8 követőbájt bitképe: 10xxxxxx. Ennek alapján a blokk minden egyes bájtjának felső # két bitjét kimaszkoljuk, és így kiszűrjük a követőbájtokat, és megszámoljuk azokat. Ezt levonva # a blokk összes bájtjának számából megkapjuk a karakterkezdő bájtok számát, amivel aktualizáljuk # a karakterszámlálót. # Annak érdekében, hogy a bájtokat sorra vevő közbenső ciklus ne Python szinten, hanem a gyors # C implementációban fusson, a felső két bit maszkolását az itertools és operator modulok eszköztárának # használatával valósítjuk meg, a számlálást pedig a count() metódussal végezzük. Ezt a bytes() # konténerre hívjuk meg, mert ekkor bájt szinten tudunk maradni. Ez azért előnyösebb annál, mintha # tuple() vagy list() lenne, mert ilyenkor a bájtok int típusú objektummá konvertálása is időt vinne el. total_chars = 0 while chunk := binfileobj.read(chunk_size): # A követőbájtok száma. continuation_byte_count = bytes(map(op.and_, chunk, repeat(0b11000000))).count(0b10000000) # További lehetséges megvalósítások: # continuation_byte_count = op.countOf(map(op.and_, chunk, repeat(0b11000000)), 0b10000000) # continuation_byte_count = op.countOf(map(op.rshift, chunk, repeat(6)), 0b10) # A blokkon belüli karakterkezdő bájtok számával aktualizáljuk a karakterszámlálót. total_chars += (len(chunk) - continuation_byte_count) return total_chars # -------------------------------------------------------------------- def count_chars_in_file5(binfileobj: ReadableBinaryStream, chunk_size: int = 1024 * 1024) -> int: if not binfileobj.readable(): raise ValueError("A fileobjektum nincs olvasásra megnyitva!") # Működési elv: # Az aktuális blokkon belüli karakterkezdő bájtokat úgy kapjuk meg, hogy a blokk bájtjai közül # töröljük az összes követőbájtot. Ezt a translate() metódussal végezzük. # Ehhez meghatározzuk az összes lehetséges követőbájt értéket. # A UTF-8 követőbájtok bitképe: 10xxxxxx. Vagyis a követőbájtok tartománya 10000000 - 10111111. # A követőbájtok értéke tehát 128 (0x80) és 191 (0xBF) közé esik. # Az összes lehetséges követőbájt possible_utf8_continuation_bytes = bytes(range(0x80, 0xC0)) total_chars = 0 while chunk := binfileobj.read(chunk_size): # A blokk bájtjai közül töröljük a követőbájtokat, így a karakterkezdő bájtok maradnak. leading_byte_count = len(chunk.translate(None, possible_utf8_continuation_bytes)) total_chars += leading_byte_count return total_chars # -------------------------------------------------------------------- def count_chars_in_file6(binfileobj: ReadableBinaryStream, chunk_size: int = 1024 * 1024) -> int: if not binfileobj.readable(): raise ValueError("A fileobjektum nincs olvasásra megnyitva!") # Működési elv: # Minden aktuális blokkban a karakterkezdő bájtokat úgy számláljuk meg, hogy minden # karakterkezdő bájtból kinyerjük azt, hogy hány követőbájt van utánuk, és ennek alapján # határozzuk meg a következő karakterkezdő bájt pozícióját. # A követőbájtok számát az erre szolgáló függvény meghívásával határozzuk meg. total_chars = 0 while chunk := binfileobj.read(chunk_size): # Megkeressük a blokkban az első karakterkezdő bájtot. for idx, utf8_byte in enumerate(chunk): if is_leading_byte(utf8_byte): break else: continue leading_byte_pos, leading_byte = idx, utf8_byte total_chars += 1 while True: new_leading_byte_pos = leading_byte_pos + num_continuation_bytes(leading_byte) + 1 if new_leading_byte_pos > len(chunk) - 1: break leading_byte_pos = new_leading_byte_pos leading_byte = chunk[leading_byte_pos] total_chars += 1 return total_chars # -------------------------------------------------------------------- def count_chars_in_file7(binfileobj: ReadableBinaryStream, chunk_size: int = 1024 * 1024) -> int: if not binfileobj.readable(): raise ValueError("A fileobjektum nincs olvasásra megnyitva!") # Működési elv: # Minden aktuális blokkban a karakterkezdő bájtokat úgy számláljuk meg, hogy minden # karakterkezdő bájtból kinyerjük azt, hogy hány követőbájt van utánuk, és ennek alapján # határozzuk meg a következő karakterkezdő bájt pozícióját. # A követőbájtok számát egy erre szolgáló, előre elkészítet konténerből kérjük ki. # Ezt egy olyan 256 elemű tuple konténerrel valósítjuk meg, amelynek indexei egy bájt # lehetséges értékei, az elemek pedig az adott értékhez tartozó követőbájtok száma. # Ha a bájtérték nem egy érvényes karakterkezdőbájt, akkor a tuple eleme -1 lesz. utf8_continuation_byte_counts = tuple( 0 if b <= 0x7F else 1 if 0xC2 <= b <= 0xDF else 2 if 0xE0 <= b <= 0xEF else 3 if 0xF0 <= b <= 0xF4 else -1 for b in range(256) ) total_chars = 0 while chunk := binfileobj.read(chunk_size): # Megkeressük az első karakterkezdő bájtot. for idx, utf8_byte in enumerate(chunk): if is_leading_byte(utf8_byte): break else: continue leading_byte_pos = idx leading_byte = utf8_byte total_chars += 1 while True: new_leading_byte_pos = leading_byte_pos + utf8_continuation_byte_counts[leading_byte] + 1 if new_leading_byte_pos > len(chunk) - 1: break leading_byte_pos = new_leading_byte_pos leading_byte = chunk[leading_byte_pos] total_chars += 1 return total_chars |
A futási időket az alábbi tesztkóddal határoztuk meg. A mérések két blokkmérettel és 1, 10, 100 és 1000 MB méretű fájlokkal történtek, amelyekben a karakterek száma a fájlmérettel azonos arányban növekszik.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 |
from timeit import timeit file_folder = r"D:\" for filesize in (1, 10, 100, 1000): file_path = rf"{file_folder}\test_text_file_{filesize}MB.txt" chunk_size = 128 * 1024 * 1024 # bájt print(f'Fájlméret: {filesize} MB. Blokkméret: {chunk_size / 1024 ** 2} MiB') with open(file_path, 'r', encoding='UTF-8', newline='') as f: total_chars = sum(len(chunk) for chunk in iter(lambda: f.read(chunk_size), '')) print('\tÖsszes karakter: {}'.format(total_chars)) # A tesztelni kívánt függvények. functions_to_test = [count_chars_in_file1, count_chars_in_file2, count_chars_in_file3, count_chars_in_file4, count_chars_in_file5, count_chars_in_file6, count_chars_in_file7] for count_chars_in_file in functions_to_test: with open(file_path, 'rb') as file: t = timeit(lambda: count_chars_in_file(file, chunk_size), number=1) print('\t{}: {:.3f}'.format(count_chars_in_file.__name__, t)) |
A futásiidő-mérések eredményeit a következő ábra táblázata foglalja össze.
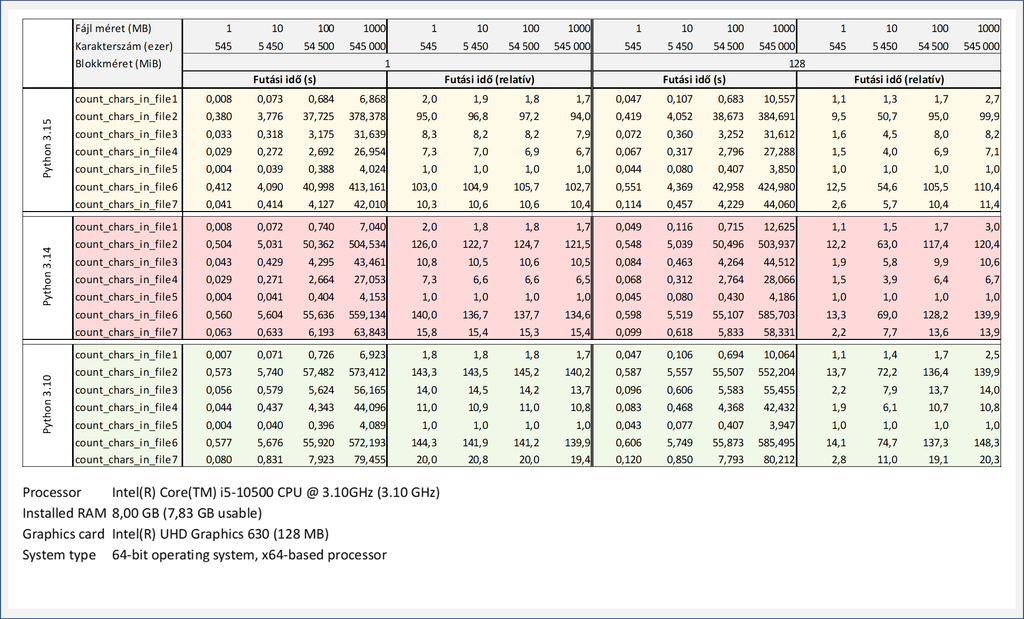
Az eredményekből látható, hogy az egyes megoldások időigénye jelentősen eltér egymástól, de jól megfigyelhető a megoldások lineáris skálázódása. A fájlméret tízszeresére növelése a futási idő hozzávetőleg tízszeres növekedését eredményezi, ami O(n) időkomplexitást jelent. A jelentős futásiidő-különbségek tehát a megvalósításuk eltérő végrehajtási idejéből adódnak.
A vizsgált esetekben egyértelműen a bytes.translate() metóduson alapuló 5. megoldás bizonyul a leggyorsabbnak, amelyet – a várthoz képest meglepő módon – a blokkok dekódolására és újrakódolására épülő 1. megoldás követ. A többi változat futási ideje ezekénél egy-két nagyságrenddel hosszabb.
A jelentős különbség oka, hogy a bytes.translate(), valamint a bytes.decode() és str.encode() metódusok a CPython implementációjában optimalizált, natív kódban végrehajtott műveletekre támaszkodnak. Ezek a megoldások a feldolgozás jelentős részét Python-szintű ciklusok és az azokban végrehajtott műveletek többletköltsége nélkül végzik el.
Ezzel szemben azok a változatok, amelyek a bájtokat egyenként, Python-szintű ciklusban dolgozzák fel, jelentős többletterhelést viselnek, ami a mérési eredményekben is megmutatkozik. Az is megfigyelhető, hogy ezeknek a megoldásoknak a futási ideje az újabb Python-verziókban csökken, ami a Python utasítás-végrehajtási mechanizmusának és a futtatókörnyezet optimalizációinak fejlődését tükrözheti.
A 6. és 7. megoldás összehasonlítása egy további érdekes különbségre világít rá. A követőbájtok számának meghatározása függvényhívás helyett egy előre összeállított konténerből történő indexeléssel jelentősen csökkenti a futási időt.
Ennek oka, hogy egy tuple-ből történő indexeléssel végrehajtott elemkiolvasás lényegesen kisebb idővel járhat, mint egy külön Python-függvény meghívása. Egy függvényhívás során ugyanis az interpreternek többek között fel kell dolgoznia a hívást, elő kell készítenie az argumentumokat, kezelnie kell a függvény végrehajtási környezetét, majd végre kell hajtania a függvény törzsében található utasításokat, és végül, át kell adnia a visszatérési értéket a hívónak. A Python aktuális implementációjától és verziójától függően ezek a feladatok különböző mértékű többletmunkát jelenthetnek.
Ezzel szemben egy tuple elemének indexeléssel történő lekérése lényegesen egyszerűbb művelet: az interpreter ellenőrzi az index érvényességét, majd a tuple belső adatszerkezetében megkeresi a megfelelő pozícióhoz tartozó objektumot, és visszaadja annak referenciáját.
A két megközelítés közötti különbség különösen akkor válik jelentőssé, ha a műveletet a bemenet minden egyes bájtjára vagy annak nagy részére el kell végezni. Ilyenkor a függvényhívások többletköltsége minden iterációban újra jelentkezhet, így az egyenként csekély különbség a teljes feldolgozás során jelentős futásidő-különbséggé halmozódhat.
A bemutatott függvények megírásához számos Python nyelvi ismeret szükséges, amelyek magyarázatokkal és példákkal mind megtalálhatók a Python tudásépítés lépésről lépésre az alapoktól az első asztali alkalmazásig című e-könyvben.